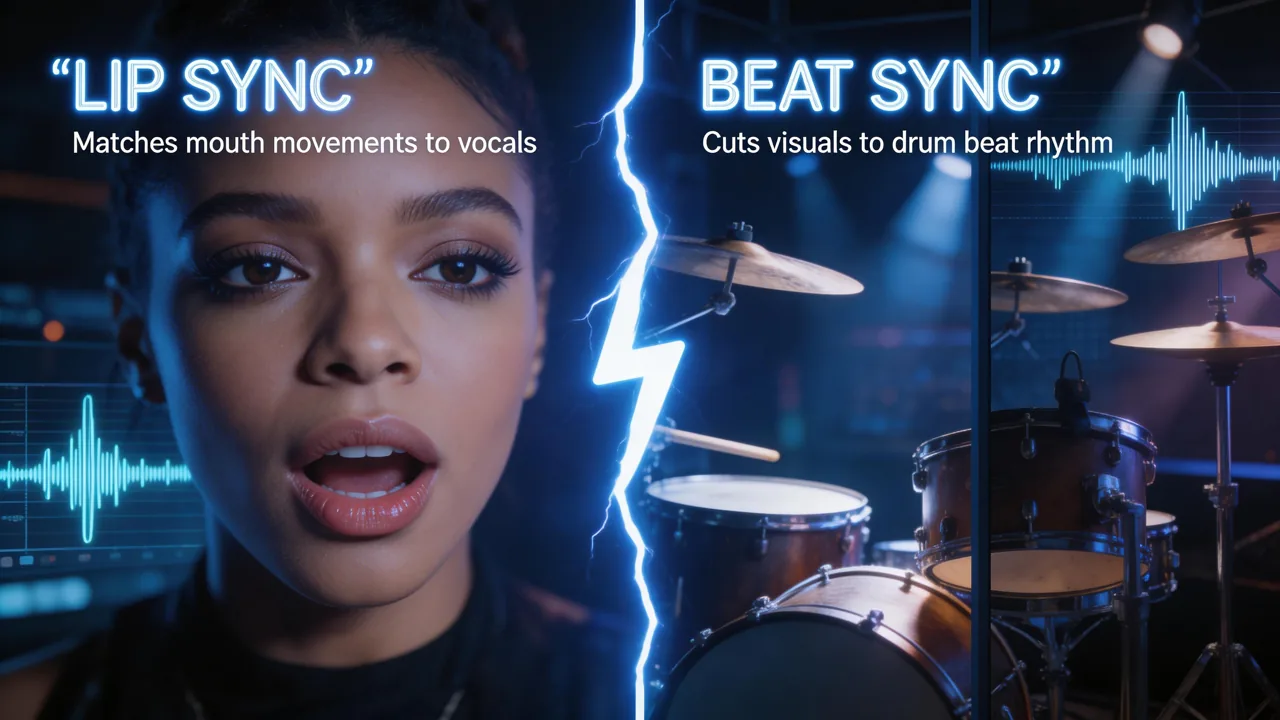
场景和口型同步解决的是不同的镜头需求。 场景根据所选起始帧和可选的视频提示词生成画面,并参考歌曲的整体能量与结构,但不保证每个重拍都对应一次硬切。口型同步根据人声音频生成可见角色的嘴部动作。在 VibeMV 中,请为每个镜头明确选择模式并审核输出。
本决策指南比较两种模式、所需输入和当前积分费率,并说明如何组合使用,而不假设音频分析会读取歌词或自动应用正确模式。
下一步该读哪篇? 如果歌曲以人声为主,请阅读把歌曲做成口型同步音乐视频。如果需要功能层面的说明,请阅读AI 口型同步音乐视频。如果从音频文件开始,请参考从音频制作 AI 音乐视频。
关键要点
- 角色需要出镜演唱时选口型同步;器乐、氛围、转场和补充画面选场景。
- 音频分析可以辅助判断结构和能量,但不会读取歌词,也不保证每次剪辑都落在重拍上。
- 为每个镜头明确设置模式,并在保留、升级到 2K 或重新生成前检查结果。
- Base 模型的场景和口型同步每生成 1 秒 2 积分;Pro 模型的两种模式每秒 8 积分;跳舞每秒 12 积分。
- 每张生成的起始帧 4 积分,可选 2K 版本按成片每秒另加 1 积分,重新生成会再次计费。
什么是节拍同步?
节拍同步是一种创作方向,让视觉变化呼应歌曲的节奏、能量或较大的结构。在 VibeMV 中,场景适合制作这类镜头:它根据所选起始帧和可选的视频提示词生成视频,并把音乐作为参考。
音频分析可以帮助识别能量变化和可能的段落边界。它不会读取歌词,也不保证每个运镜、转场或剪辑都精确落在重拍上。请把输出当作需要审核的生成镜头。
场景适合器乐段落、前奏、桥段、转场、风景、抽象视觉和补充画面,也能避免在脸太小、角度偏或被遮挡时强行生成嘴部动作。更完整的流程请参阅如何用 AI 制作音乐视频。
什么是口型同步?
口型同步根据人声音频生成嘴部动作,让可见角色看起来像在演唱。脸部和嘴部清晰、人声明确时最适合使用。
VibeMV 不要求输入歌词,音频分析也不会读取具体文字。请在需要角色演唱的每个镜头上明确选择口型同步。使用正面、嘴部可见的起始帧,并检查生成结果的时间对齐、脸部稳定性和表情。
密集说唱、重度处理的人声、侧脸、嘴部遮挡和过长连续镜头都可能暴露同步问题。长片段投入积分前先测试短区间。准备与诊断请阅读完整 AI 口型同步指南,制作步骤请参考把歌曲做成口型同步音乐视频。
并排比较
| 选择 | 适合场景 | 当前费率 | 主要审核点 |
|---|---|---|---|
| Base 模型 + 场景 | 器乐、氛围、转场、补充画面 | 每生成 1 秒 2 积分 | 节奏感与视觉连续性 |
| Base 模型 + 口型同步 | 人声表演镜头 | 每生成 1 秒 2 积分 | 嘴部时间与脸部稳定性 |
| Pro 模型 + 场景 | 成本较高的场景生成 | 每生成 1 秒 8 积分 | 节奏感与视觉连续性 |
| Pro 模型 + 口型同步 | 成本较高的人声表演生成 | 每生成 1 秒 8 积分 | 嘴部时间与脸部稳定性 |
| 跳舞 | 全身舞蹈动作 | 每生成 1 秒 12 积分 | 身体一致性与舞蹈动作 |
场景和口型同步只有在同一模型等级内费率相同。每张生成的起始帧消耗 4 积分。可选 2K 版本按成片每秒另加 1 积分。重新生成会创建另一个计费结果,因此重新生成或升级到 2K 前先审核第一版。
Free 积分和单独购买的积分包仅允许个人用途。Hobby、Pro 和 Studio 订阅允许商业用途,但你必须拥有上传音频、图片和其他素材所需的权利。当前方案详情请查看价格。
何时使用节拍同步
镜头需要表现节奏、氛围或动作,但不需要角色开口演唱时,可以选择场景。器乐前奏、独奏、转场、风景、抽象视觉和补充画面都是实用场景。
脸太小、角度偏、被遮挡或根本不出现人物时,场景也更稳妥。请检查生成动作是否支持歌曲能量、相邻镜头能否顺畅衔接,不要假设每次视觉变化都会落在重拍上。
短视频规划可参考用 AI 制作 TikTok 音乐视频。
何时使用口型同步
可见角色需要表演清楚的人声时,可以选择口型同步。适用场景包括副歌特写、短人声钩子、虚拟艺人表演、翻唱片段,或同一作品的另一种语言人声版本。
判断依据是实际镜头和音频,而不只是音乐类型。使用正面且容易看清的起始帧;密集说唱或重度处理的人声先做短测试,再检查时间对齐与表情,然后决定是否制作更长序列。
说唱歌曲的准备方法请参考如何用 AI 制作说唱音乐视频。
混合方法:按镜头选择
歌曲可以在人声、器乐和过渡段落之间变化。不要给整个项目只设一种模式,而要为每个镜头选择合适的模式。
| 歌曲段落 | 可考虑的模式 | 原因 |
|---|---|---|
| 器乐前奏 | 场景 | 建立氛围,避免不必要的嘴部动作 |
| 清晰人声特写 | 口型同步 | 让角色表演这一句 |
| 快速或重度处理的人声 | 短口型同步测试或场景 | 先检查同步,再决定是否生成长镜头 |
| 重拍、独奏或补充画面 | 场景 | 优先表现动作与氛围 |
| 全身编舞 | 跳舞 | 使用专门的舞蹈流程 |
| 最后的人声副歌 | 口型同步 | 把焦点拉回表演者 |
音频分析可以辅助判断结构和能量,但不会读取歌词,也不会替你应用正确模式。请检查音频,在每个镜头上明确选择场景、口型同步或跳舞,并审核生成结果。无法保证每次剪辑都精确命中重拍。
按镜头选择有助于在同一项目中安排表演、氛围与动作,但这仍是编辑决策:你决定角色在哪里演唱、哪些段落由视觉场景承载,以及哪些结果值得保留。5 分钟教程介绍更完整的项目流程。
常见问题
AI 音乐视频中口型同步和节拍同步有什么区别?
口型同步根据人声音频生成可见角色的嘴部动作。节拍同步让视觉变化呼应节奏或能量;在 VibeMV 中,这类镜头使用场景模式。场景不保证每次剪辑都精确落在重拍上。
音乐视频应该选口型同步还是节拍同步?
角色需要清楚地表演人声时选口型同步。氛围、动作、器乐或补充画面更重要时选场景。许多项目会在不同镜头中使用两者。
一个音乐视频可以同时使用两者吗?
可以。请在每个镜头上明确选择场景或口型同步。音频分析可以辅助判断结构,但不会读取歌词或自动应用正确模式,因此你需要自己审核音频和每个生成结果。
积分费率如何比较?
Base 模型的场景和口型同步每生成 1 秒 2 积分,Pro 模型的两种模式每秒 8 积分,跳舞每秒 12 积分。每张生成的起始帧 4 积分,可选 2K 版本按成片每秒另加 1 积分,每次重新生成都会再次计费。
口型同步还是节拍同步生成得更快?
不要依赖固定时间承诺。生成时间会随片段长度、所选模型和模式、队列情况以及后续处理而变化。应比较生成镜头和积分成本,而不是假设某种模式一定在固定分钟数内完成。
总结
镜头需要承载节奏、氛围、转场或补充画面时选择场景;可见角色需要演唱清晰人声时选择口型同步;全身舞蹈动作选择跳舞。请为每个镜头明确选择并审核结果:音频分析不会读取歌词,生成的视觉变化也不保证每次都命中重拍。
更多工具比较请查看最佳 AI 音乐视频生成器。输入准备和口型诊断请参考完整口型同步指南与最佳口型同步工具比较。音频转视频教程介绍完整起步流程。
准备测试两种方法?请从 AI 音乐视频生成器开始,并在生成前用价格估算每个镜头的成本。